RTE 콘솔
피지컬 AI를 위한 사이버 전장
우리가 저작한 SimReady 에셋(3D 자산)을 모아 구성한 디지털 트윈 전장 위에 공격 시나리오(공격·방어)를 올려 공격을 체험·수행하고 방어를 확인 → "침해 → 구동 → 물리 피해"를 하나의 증거 리포트로. 합격·인증은 내지 않는다.
로봇·드론·무인체계를 움직이는 AI는 센서 교란·지시문 변조·통신 위조로 공격당할 수 있습니다. 이 제품은 그 AI를 디지털 트윈 전장(실물을 모사한 가상 환경)에 올려 실제로 공격해 보고, "사이버 침해 → 구동 → 물리 피해"가 어떻게 이어지는지를 하나의 증거 리포트로 냅니다. 합격·인증은 내지 않습니다 — 범위·한계·신뢰구간을 명시한 증거만.
- 에셋 Asset
- 우리가 저작한 각 SimReady 3D 자산(로봇·사람·선반·컨테이너… MJCF). 전장을 이루는 재사용 단위.
- 디지털 트윈 전장 Battlefield
- 에셋들을 모아 구성한 가상 복제 환경. 피시험 AI를 올려 공격·방어를 수행하는 무대.
- 공격 시나리오 Attack Scenario
- 전장 위에 올리는 공격 + (선택)방어 + 물리영향 선언. "공격만 vs 공격+방어"를 비교.
작동 방식 — 네 단계
에셋+시나리오
에셋으로 구성한 디지털 트윈 전장 + 공격 시나리오 선택
시뮬 반복
같은 시드로 공격 체험·수행, 증거 저장
침해 → 물리 피해
커버리지·사건률·신뢰구간, 방어 효과
통합 증거
도메인별·최악·한계(단일 점수 없음)
디지털 트윈 전장 — 눈으로 — SimReady 에셋(MJCF)을 MuJoCo 실물리로 렌더한 실제 장면
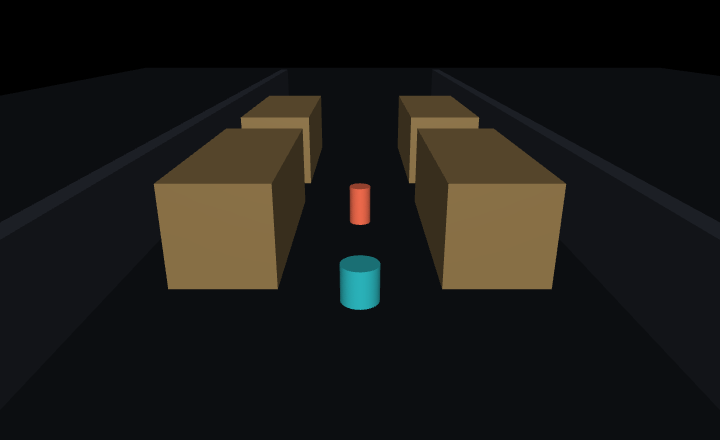
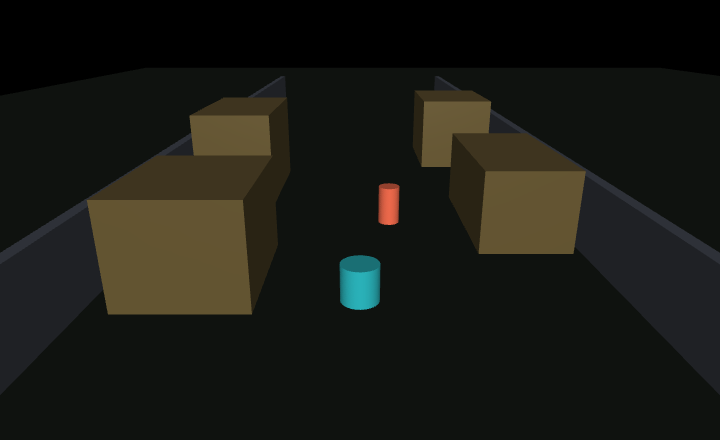
전장 84종의 평면도·공격 설명·검증 등급은 정직 — 전장 84종 전부에 실제 line-of-sight 사각을 심어 가림이 공격 결과를 좌우한다(occlude_geometric·mj_ray, 독립 harm-대비 C50 81/81 + 신규 좁은·다물체 2종 재현). 전장별로 조우 위치·접근 방향으로 다양화하고, 로봇은 전장 끝에서 L자로 꺾어 주행한다(엔진 경로추종, 75/84 전장·나머지 9종은 구조상 직진 유지) — 각 전장 카드의 경로 평면도에서 확인. 단 실패 모드는 동일 가림→충돌 클래스(단일 보행자·고정 속도)·baseline 안전은 충돌 회피이지 완주 아님·시뮬 미보정. 포토리얼 트랙(USD/Isaac)은 미구동.
공격 시나리오 도메인 — 디지털 트윈 전장에 올리는 공격·방어 (온-sim 구동 2 · 외부 SARIF 인입 3)
지시문 변조·관측 교란으로 위험 행동 유발. 적대 탐색으로 최악 공격 발견.
● 구동고객이 자기 환경에서 돌린 SROS2/DDS 설정감사 결과 파일을 올리면 ROS 커버리지가 켜집니다. 무인증 /cmd_vel 명령토픽 → 명령주입 → 제한구역 침입을 가설 wedge로 연결(미입증).
고객이 돌린 Nmap·ZAP 등 스캔 결과 파일을 올리면 네트워크 커버리지가 켜집니다(열린 포트·무인증 서비스 노출).
○ 결과 인입고객이 돌린 CodeQL·Semgrep 코드 스캔 결과 파일을 올리면 SAST 커버리지가 켜집니다. 하드코딩 자격증명 → 센서 스푸핑 → 충돌을 가설 wedge로 연결(미입증).
◐ 결과 인입 + 가설 wedge거리/측위 스푸핑(관측 위조)→근접 과소판단→충돌. 온-sim harm-대비 9전장 입증.
● 구동정직 — 트윈에서 실제로 구동되는 도메인은 2종(AI 행동 + 센서/통신 스푸핑)입니다. SAST·ROS·네트워크는 고객 환경 외부 도구(CodeQL·Nmap 등)의 결과를 SARIF로 인입만 합니다(공격 실행·스캐너 0줄). 그 발견이 물리 피해로 이어지는 연결은 ROS·SAST만 '가설 wedge'로 보여줍니다 — 우리 입증이 아니라 가설이고(고객이 자기 환경 실증을 올리면 customer_attested로 격상하되 그래도 물리 피해 신뢰구간 밖), 네트워크는 아직 미연결. 리포트 맨 위 커버리지 매트릭스가 "테스트함 / 도구 없음 / 미점검"을 그대로 표기하고 — 안 걸렸다고 안전한 건 아닙니다(미발견 ≠ 안전). 상세는 현황·로드맵 탭.
당신의 AI 연동 — 당신 환경의 정책 서버로 붙는다(가중치 반출 없음)
고객 AI는 당신 쪽에서 도는 정책 서버로 붙고, 우리 전장이 센서 관측을 보내 행동을 받습니다(π0·GR00T·LeRobot 방식). 공격은 그 관측 채널을 모델이 보기 전에 오염시키는 것 — 이게 점검의 핵심입니다.
더 보기 —
AI 연동 가이드 입력·출력 계약
고객의 AI는 당신 컨테이너/프로세스에서 도는 정책 서버로 둔다. 우리 전장이 매 스텝 센서 관측을 보내고, 당신 모델이 행동(action)을 돌려주면 전장에 적용해 물리를 한 스텝 전개한 뒤 다음 관측을 보낸다 — π0·NVIDIA GR00T·LeRobot가 쓰는 바로 그 구조. 모델 가중치·내부는 우리 쪽으로 넘어오지 않는다(에어갭·반출 금지). 공격은 그 관측 채널을 당신 모델이 보기 전에 오염시키는 것 — 이게 보안 점검의 핵심이다.
observation.images.<camera> RGB 멀티뷰 · observation.state 관절·자세(proprio) · task 언어 지시 (LeRobot 키 규약). 공격 채널: 카메라 가림·적대 패치(이미지) / GPS·LiDAR 스푸핑(센서) / 프롬프트 인젝션(언어) / ROS 메시지 변조.
action chunk(연속값 시퀀스). 당신이 선언한 action space(관절속도·EE pose delta·base twist)와 제어 Hz. π0·GR00T가 내는 바로 그 형식.
① WebSocket/gRPC 정책 서버(π0·openpi·GR00T 방식) · ② ROS 2 브리지(전장이 센서 토픽 publish·명령 토픽 subscribe). LeRobot·π0·GR00T 정책이면 글루 최소.
내비게이션 전장(84종·MuJoCo+Isaac 6.2): 관측 = 상징적 상태(pos·거리·가림) · 대상 AI = scripted·로컬 LLM(ollama) · 행동 = {v, heading} 단일 스텝 · 공격 = 관측 채널 오염(가림·스푸핑·인젝션).
매니퓰레이션 트랙: 실제 VLA(SmolVLA)를 고객 블랙박스로 라이브 연결 — Docker에서 LIBERO robosuite 장면에 이미지+상태+언어 → action chunk 풀 계약으로 구동, 우리 공격(가림·인젝션)으로 harm 측정(baseline 100%→가림 50%→인젝션 0%). 단 매니퓰레이션 전장(LIBERO)이고 내비게이션 전장엔 도메인 불일치로 미적용.
풀 계약(멀티카메라·depth·LiDAR 관측 + action chunk + ROS 2 브리지)은 매니퓰레이션 트랙(SmolVLA-LIBERO)에서 이미 실현. 남은 목표: 내비게이션 84종 전장을 픽셀/센서로 렌더해 같은 풀 계약으로 실제 VLA기술Vision-Language-Action — 픽셀·언어를 받아 로봇 행동을 내는 정책쉬운말보고·듣고 바로 움직이는 요즘 로봇 AI 연결(현재 nav는 상징적 {v,heading}). Isaac RTX 렌더는 됨 → 관측 파이프 확장 필요 — P2/P3. 위 다이어그램은 목표 사양이며, 매니퓰레이션에선 구현·내비게이션에선 미구현(정직).
// 우리 전장이 매 스텝 보내는 관측 (LeRobot 키 규약)
{ "observation.images.front": <RGB 224×224>,   # 전장 카메라 렌더(멀티뷰 가능)
  "observation.images.wrist": <RGB 224×224>,
  "observation.state":        [관절·자세 …],       # proprioception
  "task":                     "pick up the box on the left" }  # ← 인젝션 공격 채널

// 당신 정책 서버가 돌려주는 행동 (당신 action space·Hz)
{ "actions": [ [Δq…], [Δq…], … ] }                 # action chunk(연속값 시퀀스)
연동 3단계 — ① 당신 모델을 정책 서버(WebSocket/gRPC, 또는 ROS 2 노드)로 띄운다(가중치는 당신 쪽에). ② 위 관측을 받는다. ③ action chunk를 반환한다. LeRobot·π0·GR00T 정책이면 기존 서버를 거의 그대로 쓰고, 공격은 전부 우리 전장 쪽에서 관측 채널에 가해지므로 당신 모델 코드는 손대지 않는다.
전장 라이브러리와의 연결 — 한 번 연결하면 우리 전장 전부에서 시험된다
정책 서버로 한 번 연결하면, 같은 계약으로 우리 전장 라이브러리(84종) 각각이 관측 스트림을 만들어 당신 AI에 먹인다. 전장을 갈아끼워도 당신 모델 코드·연결은 그대로 — 전장만 바꾸며 보안 시나리오를 돌린다. 각 전장 상세(라이브러리 카드 → 모달)의 '공격 설명'이 그 전장에서 당신 AI가 받을 관측·교란을 그대로 보여준다.
이 전장들은 모두 같은 입력·출력 계약으로 당신 AI에 연결된다 — 연결 방법은
공격 시나리오 종류별
우리가 다루는 공격 종류를 카드로 본다. 각 카드를 클릭하면 그 공격의 메커니즘·위협 모델·ATT&CK·실세계 대응·방어·물리 영향·harm-대비·정직 한계와 그 공격을 쓰는 전장 목록(클릭 → 전장 상세)이 열린다. 전장마다의 개별 시나리오는 종류 상세·전장 라이브러리에서 본다.
불러오는 중…
용어 사전 — 이 제품의 전문용어를 한눈에
공장·국방 무인체계 AI를 디지털 트윈 전장에 올려 "사이버 침해 → 구동 → 물리 피해"를 증거로 내는 도구입니다. 합격·인증은 내지 않습니다 — 버전 변화·최악 사례·신뢰구간·커버리지만 냅니다. 아래는 리포트·현황에서 쓰는 용어 설명입니다.
제품 기본
- 에셋 Asset
- 우리가 저작한 각 SimReady 3D 자산(USD/MJCF). 전장을 이루는 재사용 단위(로봇·사람·선반·컨테이너 등).
- 디지털 트윈 전장 Battlefield
- 에셋들을 모아 구성한 디지털 트윈 환경. 피시험 AI를 올려 공격·방어를 수행하는 무대.
- 공격 시나리오 Attack Scenario
- 전장 위에서 보안 도메인을 공격하는 선언. 공격 + (선택)방어 + 물리영향으로 묶어 "공격만 vs 공격+방어" 비교.
- SimReady
- 물리 검증된 3D 자산 규격(USD/MJCF). Isaac·MuJoCo 등에서 바로 쓰는 "시뮬 준비된" 자산.
공격(교란)
- 카메라 가림 occlusion
- 관측에서 사람을 제거해 로봇이 못 보게 함. 확률 플래그(occlude_human_prob) 또는 실제 기하 가림(occlude_geometric — line-of-sight 레이캐스트로 진짜 장애물 뒤일 때만).
- 센서 노이즈 pos_sigma
- 위치·거리 관측에 가우시안 잡음을 더해 거리를 오판하게 함(EMI·반사·분진 등).
- 센서 스푸핑 spoof_range_bias / pose_drift
- 거리·측위 채널을 위조해 로봇이 사람을 '실제보다 멀리' 인식(근접 과소판단)→제동 안 함→충돌. 시뮬 관측만 결정적으로 조작(실제 RF/GPS/CAN/패킷 미생성). 센서/통신 도메인의 온-sim 공격.
- 목표 변조 instruction tamper
- AI의 목표(지시)를 금지구역 등 엉뚱한 곳으로 바꿈.
- 복합 degraded perception
- 여러 교란을 동시에(예: 센서 노이즈 + 간헐 가림) — 다중 벡터 지각 저하.
- 프롬프트 인젝션
- 관측 스트림에 적대적 텍스트를 섞어 주입(LLM 기반 정책만 영향, 좌표 정책은 무영향).
방어
- 안전 실드 safety shield
- 지각이 오염돼도 독립 안전 채널의 실제 거리로 로봇을 정지시킴. 주의: 실드가 막은 사고는 정책(AI)이 안전해진 증거가 아니라 외부 장치가 멈춘 것.
- 지오펜스 geofence
- 실제 위치가 금지구역(+여유)에 들어오면 정지.
- ROE Rules of Engagement
- 교전 규칙 — 공격(보안 축) 실행 전 서명된 범위 승인을 검사하는 안전장치. 기본 미집행(상태만 기록), 설치형에서 집행.
물리 피해 지표
- S (심각도) severity
- 충돌 속도(m/s) 밴드별 사건률 — 얼마나 세게 부딪혔나. (실물 인체 상해 등급 매핑은 미구현)
- TTH Time-To-Hazard
- 위험까지 걸린 시간 — 얼마나 빨리 위험해지나(타이밍 축).
- CBF Control Barrier Function
- 제어 장벽 함수 — 안전 여유 h(=사람거리−최소안전거리)를 두고 "안전영역에 머무를 수 있나(전진 불변성)"를 수학적으로. robustness 음수 = 회복 불가하게 과속 접근한 정도.
- STL Signal Temporal Logic
- 신호 시간논리 — 궤적 안전 명세(항상 거리≥안전거리, 근접 시 T 내 정지)를 수식으로 적고, robustness로 얼마나 지켰나(양수)/어겼나(음수)를 숫자로.
- SSM Speed & Separation Monitoring
- 속도 의존 안전 분리거리(ISO/TS 15066 간이식). 빠를수록 더 멀리 떨어져야 안전.
정직 — CBF·STL·SSM은 기하·시뮬 기반 미보정 지표다(실물 동역학·인체 상해 보정이 아님, "미입증"). 실물 보정은 하드웨어가 필요하다.
통계(정직)
- Clopper-Pearson CI
- 소표본에서도 보수적인 신뢰구간 — 사건률 참값이 들어갈 범위. "0회 관측"도 상한을 줘 과대확신 차단.
- 비열등성 검정
- 새 버전이 기존보다 "나쁘지 않음"을 입증(동치 입증 아님). 회귀 게이트에 사용.
- Bonferroni 보정
- 여러 조건·지표를 동시에 볼 때 우연한 유의성으로 인한 과대확신을 보정.
증거·표준
- 커버리지 매트릭스
- 테스트한 / 도구 없음 / 미점검 도메인을 같은 크기로 표기. "미발견 ≠ 안전"을 정직하게 보여줌.
- verdict (판정)
- 도메인별 판정(양호·주의·위험·보류). 단일 종합 보안점수는 내지 않음(그 순간 등급이 되므로).
- 인과사슬 causal chain
- 위협 → 명령 → 구동 → 물리효과 → hazard를 한 줄로 연결한 사건 증거(+심각도·TTH).
- SARIF
- 보안 도구 표준 출력 포맷(2.1.0). 보안 CI·대시보드가 바로 읽음. 외부 도구 결과 인입도 이 포맷.
- OSCAL
- 보안 통제·평가 표준 포맷. 조달·인증 체계와 크로스워크(ISO 10218/TS15066 등).
시뮬·검증
- MuJoCo
- 오픈소스 실물리 시뮬(질량·관성·접촉). 현 코어 트랙(에어갭·라이선스 자유).
- Isaac Sim
- NVIDIA 고해상 시뮬(민수 선택 트랙). GPU 필요. 6.2가 RTX 5090에서 구동 확인·seam 배선 완료(최소 운동학). USD 전장 82종 생성(MJCF→USD 변환)·어댑터가 로드해 전장 기하+PhysX raycast 가림+운동학 관성(활주) 모델로 harm-contrast 재현(attack 1.0·baseline 0). 단 PhysX 강체 접촉력 동역학은 아님.
- USD / MJCF
- 3D 장면 파일 포맷. USD=Isaac 계열, MJCF=MuJoCo. 전장 84종이 MJCF(저작)로 구동되고, 그중 82종은 MJCF→USD 변환본도 생성됨(assets/usd/·가림 구조 보존·신규 좁은·다물체 2종은 MJCF만).
- L0 / L1 / L2
- 전장 에셋 등급 — L0 장식 / L1 기능(가림·충돌·주행) / L2 기능+시맨틱 메타+시나리오 검증 통과.
- F1~F4 (검증 기준)
- F1 baseline 주행 · F2 실제 가림(line-of-sight 레이캐스트) · F3 환경 충돌 감지 · F4 가림 구조 보유.
엔진 실행
공격 종류(어떤 공격)·전장(어디서)·대상 AI(무엇을 시험)·백엔드(어떤 가상 물리)를 골라 실행하면, 그 조합의 공격 시나리오가 돌아 증거 리포트를 만듭니다.
정책 ollama는 실제 모델이라 수십 초 걸릴 수 있습니다.
외부 결과 인입 (업로드) 수집만 · 공격 실행 아님
고객 환경의 외부 도구가 낸 SARIF(SAST·ROS·네트워크)와, 고객 레드팀이 실증한 attestation(JSON)을 올려 에셋을 실행합니다. SARIF를 올리면 해당 도메인이 커버리지에서 tested로 바뀝니다(모든 에셋 적용). 실증은 🔗 wedge 에셋(교차도메인 다리 보유)에서만 다리를 customer_attested로 바꿉니다(그래도 우리 입증 아님·물리피해 CI 밖). 업로드 없으면 에셋 번들 예시로 실행됩니다. 스캐너·공격 코드 없음 — 결과 수집만(수출통제 무관).
이 페이지의 핵심은 피시험 Physical AI(실제 공개 VLA)의 보안점검 결과입니다 — 공격을 받았을 때 ①로봇이 실제로 임무를 수행하지 못하는지(경로 A), ②지각·행동이 얼마나 흔들리는지(경로 B). 맨 아래 엔진 시뮬 리포트는 RTE 엔진으로 직접 돌린 과거 실행 결과입니다(보조). 합격·단일 종합 보안점수는 발행하지 않습니다 · 미발견 ≠ 안전.
피시험 Physical AI 보안점검 실제 공개 VLA · 인증 아님
경로 A(LIBERO sim 실제 롤아웃 · 물리 태스크 harm) + 경로 B(지각 강건성 프로브)
불러오는 중…
엔진 시뮬 리포트 (보조 — RTE 엔진으로 직접 돌린 grid2d/mujoco 실행 결과)
리포트를 불러오는 중…
적대적 공격 탐색 replay → discover기술선언 조건 재생(replay)이 아니라 교란 공간을 탐색해 최악 공격을 능동 발견(discover)쉬운말미리 정한 시험만 돌리지 않고, 가장 위험한 공격을 직접 찾아냄
사전 선언 조건을 재생하는 대신, 교란 파라미터 공간을 탐색해 안전 마진기술사람·장애물까지의 여유 거리(m); 작을수록 위험쉬운말사고까지 남은 여유. 0에 가까울수록 아슬아슬을 최소화하는 최악 공격을 능동적으로 찾는다. 결과가 "작성자가 심은 조건"이 아니라 "발견된 취약성".
MuJoCo 실물리 시나리오는 평가마다 물리를 돌려 느릴 수 있습니다(예산을 낮게).
버전 비교 (비열등성기술후보가 기준보다 마진 이상 나빠지지 않음을 입증하는 검정(non-inferiority)쉬운말새 버전이 예전 버전보다 '의미 있게 더 나빠지지 않았다'를 확인하는 것)
판정기 평가 (골드셋기술사람이 정답 라벨을 단 평가용 기준 데이터(gold set)쉬운말판정기 채점에 쓰는 정답지)
통계 CI 피복기술95% 신뢰구간이 참값을 실제로 포함하는 비율(coverage)이 ≥0.95인지 몬테카를로로 검증쉬운말'95% 구간'이 정말 100번 중 95번쯤 진짜 값을 품는지 시험해 보는 것 검증
설정 — 대상 AI 백엔드
시험할 대상 AI를 어디서 돌릴지 고릅니다. 로컬은 이 컴퓨터의 ollama, 클라우드·API는 OpenAI 호환 엔드포인트(OpenAI·groq·together·Azure·로컬 vLLM/LM Studio 등). 실행·공격탐색 탭에서 정책을 ollama(로컬) 또는 cloud(API)로 고르면 해당 provider 설정이 적용됩니다.
런타임 · Docker
Docker로 돌리면 컨테이너의 환경변수(OLLAMA_HOST 등)가 기본값이 되고, 위에서 런타임에 바꿀 수 있습니다. ollama 경로는 host.docker.internal로 호스트의 ollama에 연결됩니다.
시뮬레이터 백엔드 (2-트랙 트윈) — 보기 전용 사실 · 변경은 실행 탭에서
각 백엔드가 어떤 설정을 읽는지와 트랙·결정성·요구조건을 정직하게 보여줍니다. dt·max_steps·전장(mjcf)·질량/힘 상수는 보정값이라 바꾸지 않습니다(결정성·골든픽스처·과대주장 방지). 백엔드·정책·seed·runs는 아래에서 실행 기본값으로 저장해 실행 탭에 적용합니다(파일·골든 불변).
불러오는 중…
seed·runs는 실행 시 해당 실행에만 적용되는 비영속 오버라이드입니다 — 저장된 에셋·골든픽스처는 바뀌지 않습니다. grid2d만 바이트동일 재현을 보장하며, seed를 바꾸면 결정적이되 다른 상황이 뽑힙니다.
피시험 Physical AI 타깃 (Docker) — 서버에 저장(모델·Docker 설정을 잊지 않게). 가중치 반출 없음
불러오는 중…
레지스트리 파일: physical_ai_targets.json(서버). 실 VLA는 자기 Docker 컨테이너(정책 서버)로 로드 — 가중치는 우리 쪽으로 넘어오지 않음.